

Muse Voice Transcribe جدیدترین مدل متا برای پردازش و رونویسی بلادرنگ صداست که با تمرکز بر تشخیص همزمان چند گوینده و پشتیبانی از زبانهای متعدد معرفی شده است. به گزارش ثروت فردا، متا اعلام کرده این مدل علاوه بر تبدیل گفتار به متن، میتواند گویندگان مختلف را از یکدیگر تفکیک کند و در مکالمات چندزبانه نیز تغییر زبان را تشخیص دهد.
متا از مدل تبدیل صوت به متن Muse رونمایی کرد؛ تشخیص همزمان چند گوینده و زبان
آزاد کبیری: مدل جدید Muse Voice Transcribe میتواند گفتار بیش از ۲۰ نفر و بیش از ۲۰ زبان را بهصورت همزمان رونویسی کند.
متا مدل جدیدی برای رونویسی لحظهای صدا با نام Muse Voice Transcribe معرفی کرد که به گفته این شرکت میتواند گفتار بیش از ۲۰ گوینده را تشخیص دهد و همزمان با چند زبان کار کند. این مدل همچنین میتواند هنگام تغییر زبان در میانه جمله، زبانهای مختلف را تشخیص دهد و متن را بر همان اساس رونویسی کند.
Muse Voice Transcribe اولین مدل پردازش صوتی بلادرنگ متا است و برای تبدیل گفتار به متن در حالت استریم طراحی شده است. این مدل قابلیتهایی مانند تفکیک گویندگان و تشخیص زمان پایان گفتار را در یک مدل واحد ارائه میکند.
مدل تبدیل گفتار به متن متا: Muse Voice Transcribe
«مارک زاکربرگ»، مدیرعامل متا، نمونهای از عملکرد این مدل را در شبکه اجتماعی ایکس منتشر کرده است. در این ویدیو، سیستم میتواند چند گوینده را از یکدیگر تشخیص دهد و هنگام صحبتکردن افراد به زبانهای مختلف، زبان گفتار را بهصورت خودکار تغییر دهد.
این مدل همچنین از قابلیتی موسوم به تغییر زبانی پشتیبانی میکند؛ به این معنا که اگر فردی در یک جمله از واژههای چند زبان استفاده کند، سیستم میتواند این تغییر را تشخیص دهد و جمله را رونویسی کند.
زاکربرگ درباره نحوه عملکرد مدل توضیح داده است: «مدل تصمیم میگیرد چه زمانی گوش بدهد. برای واژههای دشوار کمی بیشتر صبر میکند و برای واژههای ساده سریعتر نتیجه را ثبت میکند.» به گفته او، این فرایند با استفاده از تأخیر تطبیقی انجام میشود تا مدل بتواند توکن بعدی را پیشبینی و دقت رونویسی را افزایش دهد.
زاکربرگ همچنین گفته است مدل برای کار با صدای واقعی و نامنظم آموزش دیده و با بیش از ۷۰ زبان آموزش داده شده است. به گفته او، Muse Voice Transcribe میتواند جلسات صوتی تا یک ساعت را با بیش از ۲۰ گوینده مدیریت کند.
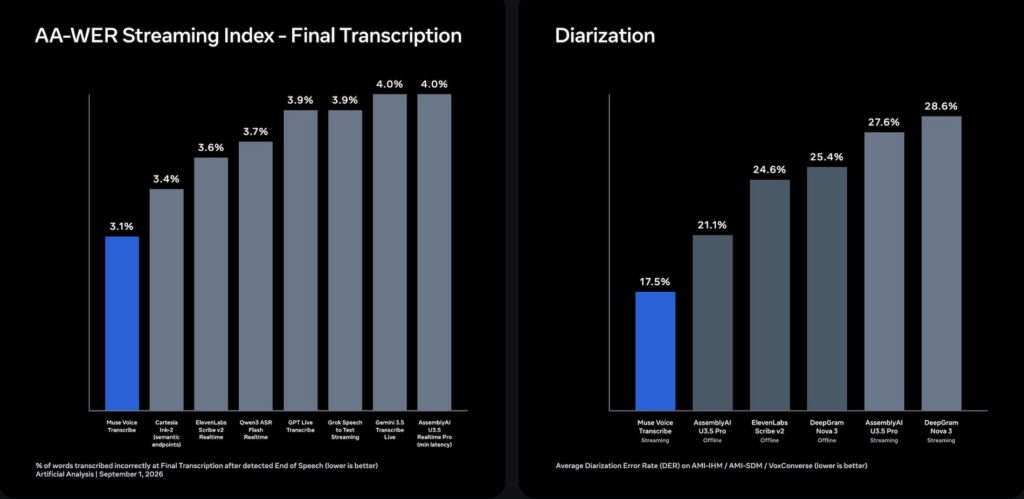
متا معرفی Muse Voice Transcribe را کمتر از یک هفته پس از معرفی مدل صوتی Gemini ۳.۵ Transcribe گوگل انجام داده است. گوگل قصد دارد مدل صوتی خود را در اندروید و در آینده در مرورگر کروم ادغام کند، اما هنوز مشخص نیست متا چه برنامهای برای استفاده از Muse Voice Transcribe در سرویسهای اصلی خود دارد.
درحالحاضر، کاربران میتوانند قابلیتهای این مدل را در اپلیکیشن دسکتاپ Meta AI برای مک تجربه کنند. این مدل برای توسعهدهندگان نیز از طریق Muse Code و Model API متا در دسترس است. هزینه استفاده از API برابر با ۳ دلار به ازای هر هزار دقیقه صوت اعلام شده است.
Muse Voice Transcribe و تحول رونویسی صوتی
Muse Voice Transcribe رویکردی متفاوت نسبت به سامانههای سنتی تبدیل گفتار به متن دارد. این مدل برای پردازش صوت بهصورت استریم طراحی شده و میتواند همزمان وظایفی مانند تشخیص گفتار، تفکیک گویندگان و تشخیص پایان صحبت را انجام دهد. متا میگوید این مدل نخستین مدل ادراک صوتی بلادرنگ این شرکت در خانواده جدید Muse است.
یکی از ویژگیهای مهم Muse Voice Transcribe، توانایی پردازش مکالمات واقعی و نامنظم است؛ شرایطی که در آن چند نفر صحبت میکنند، افراد حرف یکدیگر را قطع میکنند یا زبان مکالمه تغییر میکند.

Muse Voice Transcribe و تشخیص چند گوینده
یکی از قابلیتهای کلیدی Muse Voice Transcribe تفکیک گویندگان است. طبق اطلاعات رسمی متا، این مدل میتواند مکالمات طولانی با بیش از ۲۰ گوینده را بدون نیاز به پردازش پس از ضبط مدیریت کند.
این قابلیت میتواند برای جلسات کاری، نشستهای گروهی، مصاحبهها و گفتوگوهای چندنفره اهمیت زیادی داشته باشد؛ زیرا خروجی رونویسی فقط متن خام نیست و مدل تلاش میکند مشخص کند هر بخش از صحبت مربوط به کدام گوینده است.
Muse Voice Transcribe و پشتیبانی چندزبانه
Muse Voice Transcribe برای کار با زبانهای متعدد آموزش دیده است. متا اعلام کرده این مدل با بیش از ۷۰ زبان آموزش داده شده و ۲۵ زبان نیز بهصورت گسترده اعتبارسنجی شدهاند. قابلیت تشخیص تغییر زبان در میان یک جمله نیز از ویژگیهای مهم آن محسوب میشود.
این ویژگی میتواند برای مکالمات بینالمللی و محیطهایی که کاربران بهصورت طبیعی میان چند زبان جابهجا میشوند، کاربرد ویژهای داشته باشد.
Muse Voice Transcribe و رونویسی بلادرنگ
تمرکز اصلی Muse Voice Transcribe بر کاهش فاصله میان صحبتکردن و نمایش متن است. متا برای این مدل قابلیتی با عنوان «تأخیر تطبیقی» معرفی کرده که میزان انتظار برای پردازش هر واژه را بر اساس دشواری آن تغییر میدهد. به این ترتیب، مدل تلاش میکند میان سرعت و دقت تعادل برقرار کند.


این فناوری میتواند تجربه کاربر در ابزارهای دیکته صوتی، دستیارهای هوشمند و برنامههای مبتنی بر صدا را بهبود دهد.
کاربردهای Muse Voice Transcribe
کاربرد Muse Voice Transcribe تنها به تبدیل فایل صوتی به متن محدود نیست. این مدل در حال حاضر برای قابلیتهای دیکته صوتی در Meta AI و Muse Code نیز مورد استفاده قرار گرفته است.
متا همچنین اعلام کرده این مدل از طریق Meta Model API، Meta AI برای مک و Muse Code در دسترس است.
این موضوع نشان میدهد متا قصد دارد فناوری تشخیص گفتار خود را علاوه بر محصولات مصرفی، در اختیار توسعهدهندگان نیز قرار دهد.
چشمانداز Muse Voice Transcribe
ورود مدلهایی مانند Muse Voice Transcribe میتواند رقابت در حوزه تبدیل گفتار به متن را افزایش دهد. ترکیب رونویسی بلادرنگ، تشخیص گویندگان، پردازش چندزبانه و پشتیبانی از مکالمات طولانی، مسیر توسعه ابزارهای صوتی مبتنی بر هوش مصنوعی را گستردهتر میکند.
در آینده، چنین مدلهایی میتوانند در جلسات آنلاین، دستیارهای شخصی، نرمافزارهای کاری، تولید محتوا و ابزارهای دسترسیپذیری نقش پررنگتری داشته باشند.


نظر شما در مورد این مطلب چیه؟